Конфигурации и цены
| Конфигурация | ₽/час | ₽/мес | Доступность | Действие |
|---|---|---|---|---|
| 1× NVIDIA RTX 4090 / 12 vCPU / 24 ГБ VRAM | 52.25 ₽ | 37 620 ₽ | Доступно | Выбрать |
| 2× NVIDIA RTX 4090 / 42 vCPU / 24 ГБ VRAM | 104.5 ₽ | 75 240 ₽ | Доступно | Выбрать |
| 2× NVIDIA RTX 4090 / 0 vCPU / 24 ГБ VRAM | 104.5 ₽ | 75 240 ₽ | Доступно | Выбрать |
| 1× NVIDIA RTX 4090 / 14 vCPU / 23 ГБ VRAM | 111.54 ₽ | 80 309 ₽ | Доступно | Выбрать |
| 4× NVIDIA RTX 4090 / 128 vCPU / 24 ГБ VRAM | 209 ₽ | 150 480 ₽ | Доступно | Выбрать |
| 4× NVIDIA RTX 4090 / 0 vCPU / 24 ГБ VRAM | 328.61 ₽ | 236 599 ₽ | Доступно | Выбрать |
| 8× NVIDIA RTX 4090 / 0 vCPU / 24 ГБ VRAM | 657.22 ₽ | 473 198 ₽ | Доступно | Выбрать |
* Цены в рублях с НДС. Почасовая тарификация без минимального срока аренды. Счёт и закрывающие документы по запросу.
Полные технические характеристики и AI/ML бенчмарки
NVIDIA RTX 4090 в базе GPUСистемные бенчмарки
Канонические MLPerf® и другие результаты на полных системах — отдельно от ориентировочных tok/s на этой странице.
Технические характеристики
- Архитектура
- Ada Lovelace
- VRAM
- 24 ГБ
- CUDA-ядра
- 16384
- Пропускная способность памяти
- 1008 ГБ/с
- TDP
- 450 Вт
- NVLink
- Нет
Подходит для
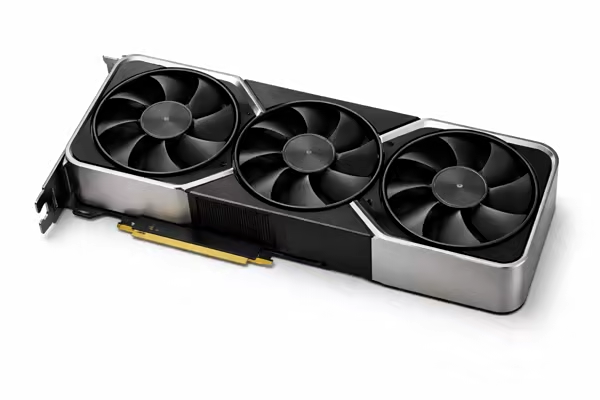
RTX 4090 — видеокарта Ada Lovelace с 24 ГБ GDDR6X. Её можно рассматривать для экспериментов на одной GPU, генерации изображений и обучения адаптеров. Вместимость определяется моделью и настройками движка.
Какие задачи проверить
Инференс небольшой модели. В инструкции для Qwen2.5 7B BF16 задан контекст 4 096 токенов и одна активная последовательность. Только веса занимают около 15,2 ГБ в десятичных единицах. Проверьте полный запрос перед увеличением контекста и параллелизма.
Генерация изображений. Начните с одного изображения нужного разрешения. Добавляйте ControlNet, апскейлер и дополнительные модели по одному, записывая пиковый расход памяти.
LoRA и QLoRA. Зафиксируйте длину последовательности, optimizer, rank адаптера и batch. Для полного fine-tuning нужен другой бюджет памяти, чем для инференса или обучения адаптеров.
Когда выбрать другую GPU
Сравнивайте с RTX 3090, если задача помещается на обеих картах. С RTX 5090 — если 24 ГБ стало мало. С A100 80 ГБ — если требуется существенно больше памяти. Дополнительная VRAM сама по себе не доказывает ускорение задачи, которая уже помещалась.
Выбор GPU · RTX 4090 против A100 80 ГБ · Стоимость задачи.
Ограничения карты и предложения
У RTX 4090 нет NVLink. Работа на нескольких GPU всё ещё возможна при поддержке со стороны ПО, но важны PCIe-топология сервера и доступные способы обмена. Две 4090 не загружают модель автоматически как одна карта на 48 ГБ.
Проверка перед длительной арендой
Запустите точный checkpoint и свой сценарий на выбранном предложении. Проверьте свободную VRAM, выполните одну типичную задачу, затем повторите с максимальным нужным входом или batch. Запишите версии движка и пиковую память. Успешная загрузка весов не проверяет вместимость всей задачи.
Расчёт памяти · Запуск LLM · Одна GPU или несколько.
Характеристики: спецификация NVIDIA. Рекомендации основаны на вместимости и требованиях задач; новые замеры скорости здесь не заявлены.
Готовые приложения на этой видеокарте
Один клик из браузера — окружение и модель уже на месте, не нужно настраивать.
Хостинг ComfyUI с Flux на облачном GPU
FLUX.1 schnell FP8 в ComfyUI на арендованной GPU: редактор в браузере, собственные workflow и готовая форма запуска.
ЗапуститьCloud Gaming PC (Linux)
от ≈50 ₽/часПолноценный Linux-десктоп со Steam, Proton и Moonlight. Войдите в свой аккаунт Steam и установите игры из библиотеки — в браузере или через клиент.
ЗапуститьПерсональный AI-чат на облачном GPU с Open WebUI
Выберите Llama 3.1, Qwen2.5 или Mistral, запустите Open WebUI с Ollama и настройте собственную сессию с моделью.
ЗапуститьSDXL в ComfyUI — фотореализм на GPU
RealVisXL V5.0 / SDXL в ComfyUI на арендованной GPU: редактор в браузере, собственные workflow и готовая форма запуска.
ЗапуститьAUTOMATIC1111 WebUI на облачном GPU
от 25 ₽/часКлассический интерфейс Stable Diffusion в один клик — SD 1.5 checkpoint уже на диске, HTTPS-доступ через личный кабинет, оплата по часам.
ЗапуститьИИ-агент для кода на своём GPU
от 80 ₽/часQwen2.5-Coder-32B через vLLM на облачной видеокарте — OpenAI-совместимый эндпоинт для CloudCompute Coder, Cline, Continue, Aider и любого совместимого клиента.
ЗапуститьChatterbox TTS: синтез речи и клонирование голоса на GPU
Запустите Chatterbox с веб-интерфейсом на собственном облачном GPU. Создавайте речь по тексту и образцу голоса, переключайте Multilingual, Original и Turbo в работающем приложении.
ЗапуститьСинхронизация губ MuseTalk на облачном GPU
от 25 ₽/часАудио-управляемая синхронизация губ за один клик: загрузите фото или видео с лицом и WAV-аудио — получите talking-head mp4. Работает на GPU от 8 ГБ VRAM.
ЗапуститьWhisper — транскрипция аудио на GPU
от 30 ₽/часЗагрузите файл в браузере и получите текст на своей видеокарте. WebUI-only v1 — без отдельного API и без обещаний диаризации.
ЗапуститьСравнение с похожими GPU
| Характеристика | NVIDIA RTX 4090 | NVIDIA RTX 4080 Super | NVIDIA H100 SXM | NVIDIA A100 |
|---|---|---|---|---|
| VRAM | 24 ГБ | 16 ГБ | 80 ГБ | 80 ГБ |
| от ₽/час | 52.25 ₽ | 34.02 ₽ | — | — |
| Подходит для | LLM inference, Генерация изображений | LLM inference (7–13B), Stable Diffusion XL | Обучение LLM, Fine-tuning больших моделей | Обучение LLM, Fine-tuning |
| Страница | Текущая | Открыть → | Открыть → | Открыть → |